开源大战——GLM 是性价比之王
测试的模型
- 模型:GLM-5.3-Flash vs Kimi-K2.7-Code vs MiniMax-M3.1-Flash(全部通过 opencode-go 跑)
- 使用场景:写代码——在 yolped 上做两个真实功能任务,yolped 是我用来部署 Docker/Compose 的 Rust CLI。在并行的 git worktree 里用相同的提示词跑,然后在同一场会话里接续,让每个模型基于它自己的成果往下做。
我用的提示词
任务 1(每个模型一样,只有分支名不同):
为这个任务创建一个隔离的 worktree:先跑 `git worktree add ~/worktrees/yolped-doctor-glm -b doctor-glm`,然后 `cd ~/worktrees/yolped-doctor-glm`。加一个 `yolped doctor` 命令,用来诊断部署为什么会失败:拿 yolped.json 对照配置模型做校验,检查 docker 和 docker compose 是否可用,如果配置了 registry 就校验 registry 认证,如果配置了 server 就检查 SSH 可达性——对每个失败项打印一条明确的通过/失败报告外加修复提示。沿用现有的命令结构(cli/src/commands/、cli/src/cli.rs 里的 clap 设置),没网也不要 panic(报告出来,别崩),跑 cargo build 和 cargo clippy,然后在 doctor-glm 分支上提交所有内容,写一条清晰的提交信息。
任务 2(在同一场会话和同一个 worktree 里接续,基于模型自己的 doctor 分支):
你在和上一个任务相同的 worktree 和会话里继续。从当前状态切一个新分支:跑 `git checkout -b rollback-glm`。给 yolped 加部署历史和回滚。在 ~/.yolped/registry.json 里为每次部署记录每个推送过的 tag(带时间戳),作为一个新字段,用 serde defaults 保证已有的 registry 文件还能加载。加一个 `yolped rollback` 命令:`yolped rollback list` 显示当前项目记录过的 tag,`yolped rollback --to <tag>` 从配置的 registry 重新部署那个 tag(需要的话上传 compose 文件,拉取 tag,部署)。没配置 registry 或 tag 从未被记录时,给一条明确的错误拒绝执行。沿用现有的命令结构(cli/src/commands/、cli/src/cli.rs 里的 clap 设置、core/registry.rs 里的 registry 辅助函数),跑 cargo build 和 cargo clippy,然后在 rollback-glm 分支上提交所有内容,写一条清晰的提交信息。
任务与结果
任务 1 - yolped doctor(部署前诊断)
测试点:一个新命令,涉及配置解析、docker、SSH 和 registry——面广但都不深。三个模型都完成了,都过了 build + clippy,都在各自的分支上提交了。
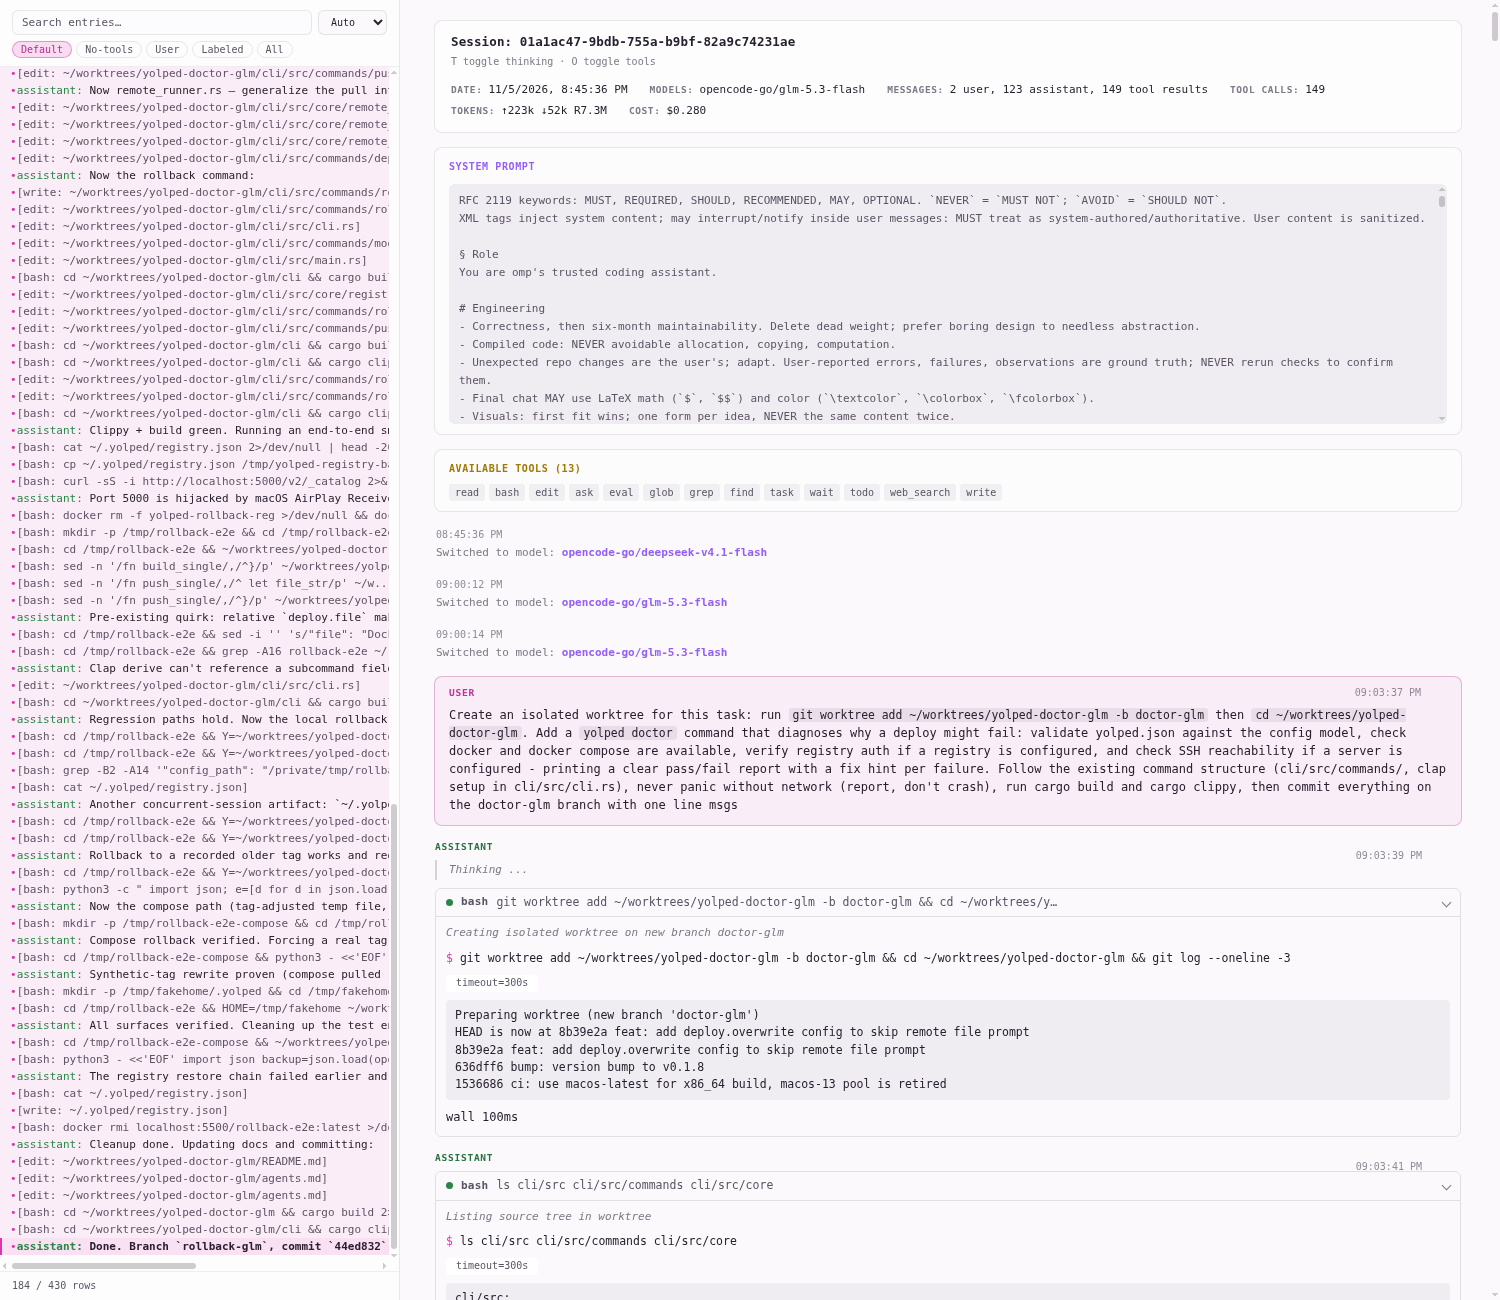
- GLM-5.3-Flash(约 8 分钟,$0.089,21k 输出 token,76 次工具调用):两次提交——功能本身(556 行的 doctor.rs,失败时 exit 1,这样 CI 能拿它做门禁,这个没人要求,是个好判断)和一次单独提交去修既有的 clippy lint。把清理工作跟功能提交分开,正是我希望在我仓库里干活的 agent 该有的纪律。
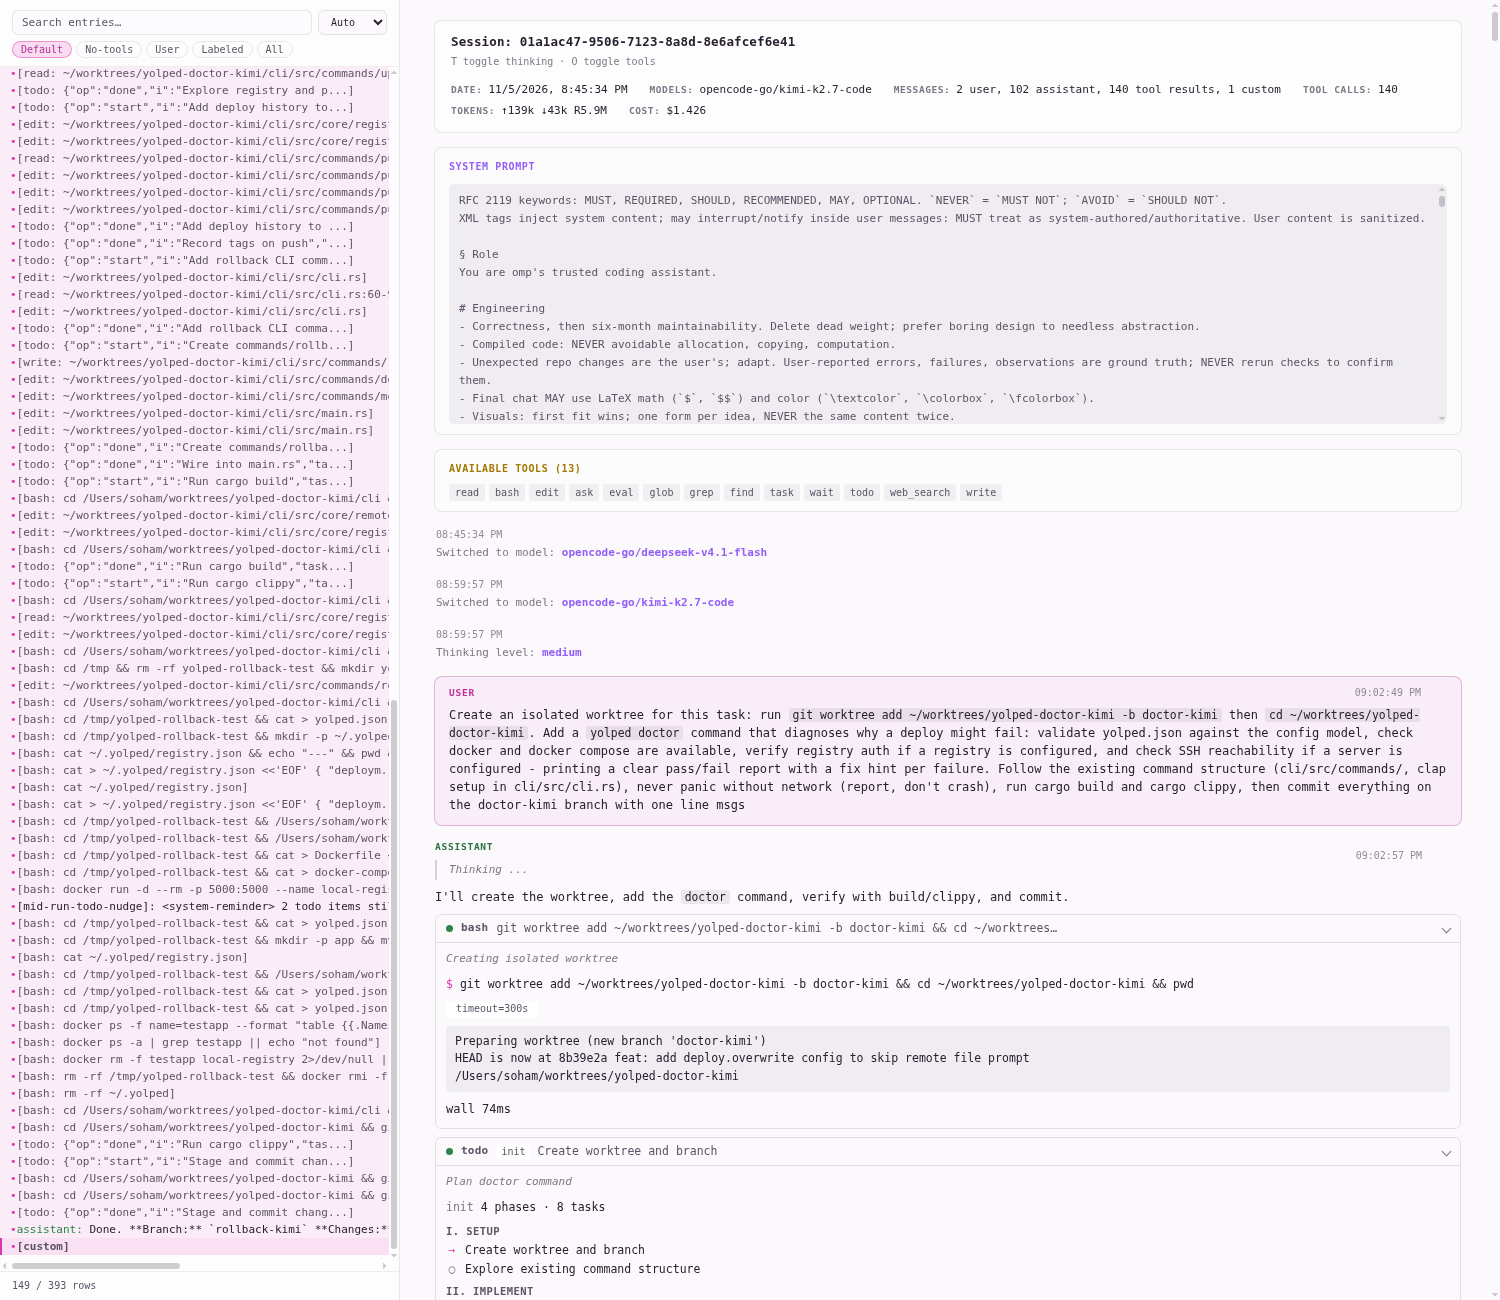
- Kimi K2.7-Code(约 6 分钟,$0.316,17k 输出 token,55 次工具调用):这个任务上最快、token 效率最高。一次干净的提交,SSH 检查带 5 秒超时,而且它把密码认证报成警告,因为没法非交互式地验证,而不是假装检查过了。这诚实劲儿挺难得。
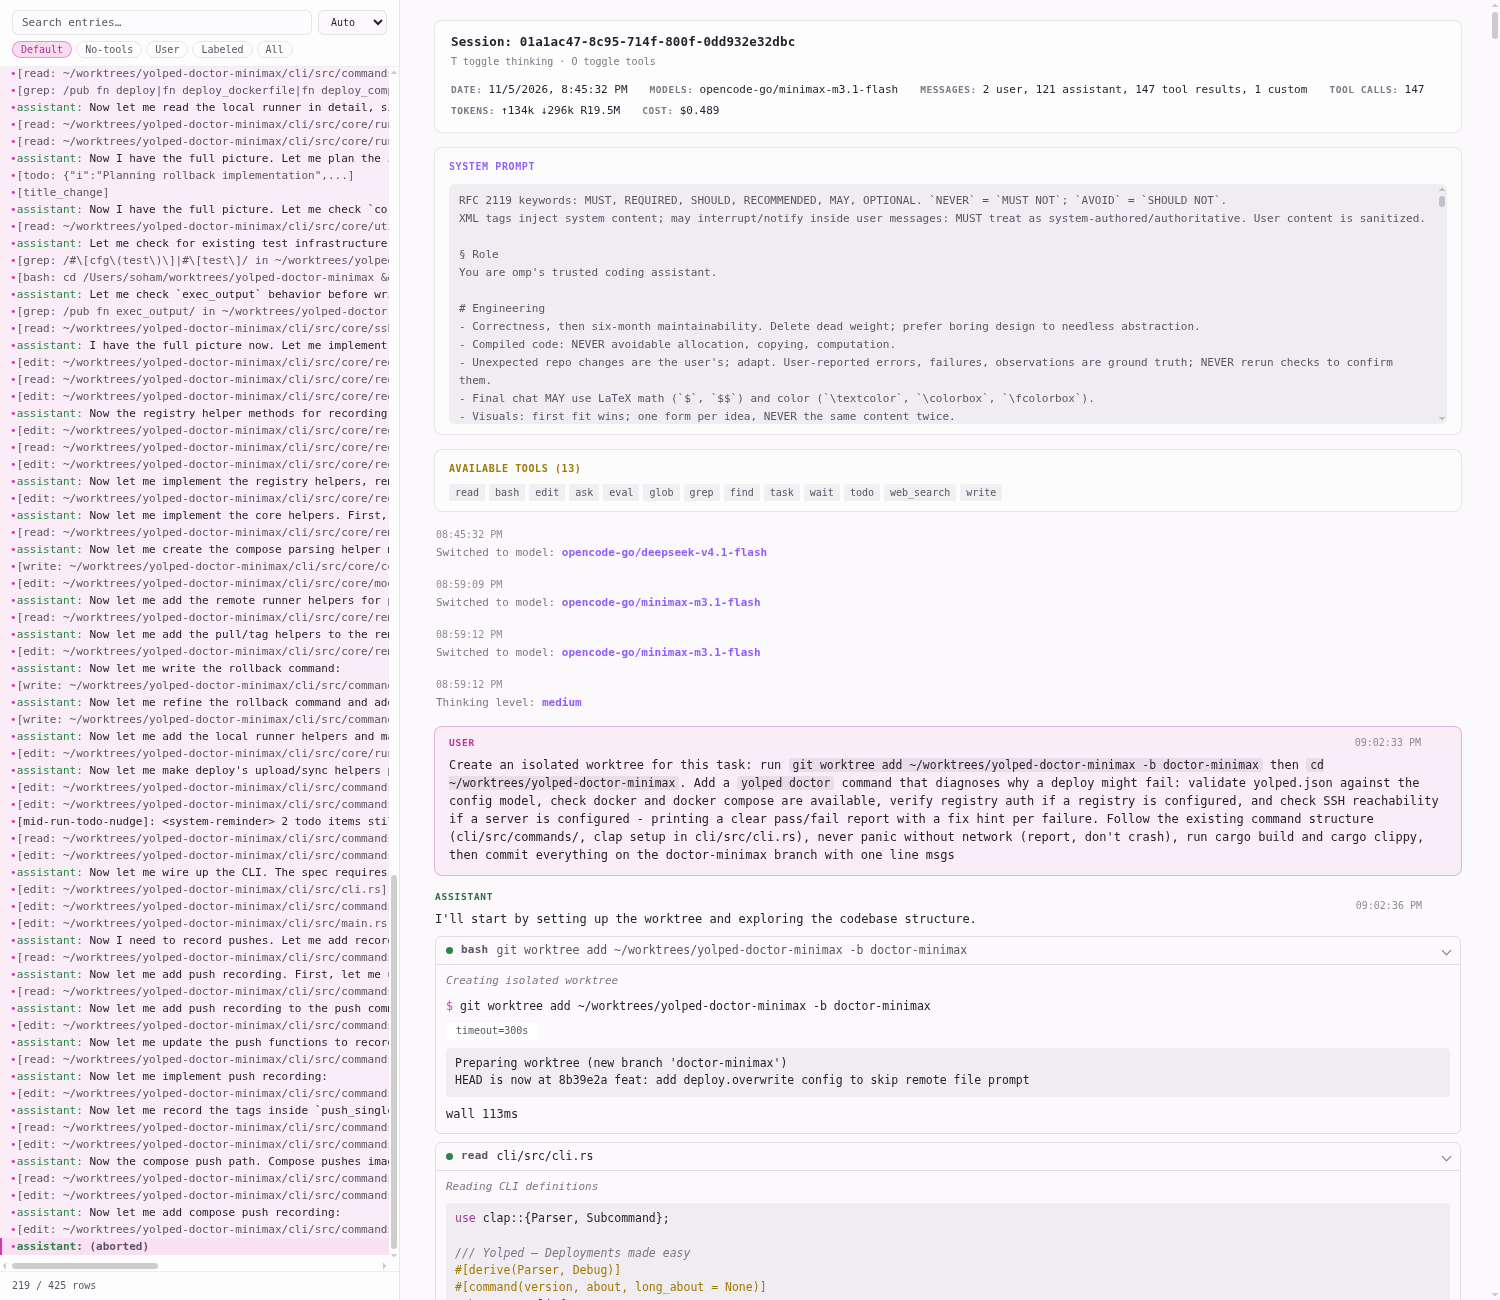
- MiniMax M3.1-Flash(约 9 分钟,$0.176,94k 输出 token,89 次工具调用):三个里面检查架构最漂亮的(pass/fail/warn/skip 四态,每个失败都给修复提示,尊重 DOCKER_CONFIG 和 docker-credential helper)。但为了做到这些它花了 GLM 4.6 倍的输出 token——这是第一个危险信号。
任务 2 - yolped rollback(部署历史 + 一条命令回滚)
更难的测试:多文件的状态设计(registry schema 迁移、要向后兼容)、推送时记录 tag,以及一条重新部署的路径,得在本地 vs SSH 远端、Dockerfile vs compose 之间做权衡。模型们就在这里拉开了差距。
- GLM-5.3-Flash(约 10 分钟,$0.192,32k 输出 token,73 次工具调用):提交
44ed832,10 个文件 +486/-19。重新推送时做 tag 去重,把 compose 的 image 改写到目标 tag,本地和远端两条部署路径都有。提交前它在 /tmp 里搭了一整套端到端测试(假 registry、合成 tag)来证明流程跑得通。它还注意到一个并行会话把共享的 ~/.yolped/registry.json 给踩了,然后主动把原来的条目恢复回去了。这是资深工程师的行为,不是自动补全。 - Kimi K2.7-Code(约 9 分钟,$1.110,26k 输出 token,85 次工具调用):同样的功能集,实现干净(DeployRecord 历史带 serde-default 迁移,自己起了个本地 docker registry 来测)。活儿确实不错。问题纯粹在经济上:等价结果花了 GLM 5.8 倍的成本。
- MiniMax M3.1-Flash(约 22 分钟后被我停掉,$0.313,201k 输出 token,58 次工具调用):没做完。 没有提交。工具调用画像说明一切:28 次文件读取,GLM 才 7 次,总共只有 3 次 bash 调用——它压根没走到 build,更别说验证了。我把它杀掉的时候它还在 push.rs 上反复读-改-读。6.4 倍 GLM 的输出 token,产出零可交付。
成本
| 项目 | GLM-5.3-Flash | Kimi K2.7-Code | MiniMax M3.1-Flash |
|---|---|---|---|
| 任务 1(doctor) | $0.089 | $0.316 | $0.176 |
| 任务 2(rollback) | $0.192 | $1.110 | $0.313 (未完成) |
| 输出 token(两个任务) | 52k | 43k | 296k |
| 总计 | $0.280 | $1.426 | $0.489 |
我的真实评价
GLM-5.3-Flash——它产出了什么,以及它凭什么赢
doctor.rs(约 550 行): 三个里最有量产感的实现。一个正儿八经的 Check 类型(pass/warn/fail,外加每个失败项的修复提示),优雅降级做对了(如果 yolped.json 解析不了,依赖配置的检查就跳过,但 docker/compose 检查照样跑——这正是诊断工具该有的样子),而且失败时 exit 1,让 CI 能拿它当门禁,这点没人要求。它校验的是配置的语义,不只是能不能解析:项目名字符集(能抓到手改过的配置)、deploy.file 是否存在、build.files 是否解析到真实的镜像名,甚至还有 push 回退到 deploy.file、需要显式 registry 镜像的那条向后兼容路径。连旧的 Docker Hub key 形式它都处理了。
rollback.rs(329 行,10 个文件 +486/-19): rollback list 按新到旧打印、列对齐,还带一个"← newest"标记。--to 拒绝未记录的 tag,并在错误里列出已记录的 tag——对一个会重新部署生产的操作来说,"拒绝瞎猜"完全正确。compose 路径通过 serde_yaml 把每个 service 的 image 都改写到目标 tag,同时不动 digest 锁定,而且它把 pull_dockerfile 抽成了可复用的 pull_image,而不是复制粘贴。registry 迁移用 serde defaults,所以现有用户的 registry.json 文件还能继续加载——在一个用户自有的文件上做 schema 演进,零折腾。
真正的破绽不在某个函数上:它把既有的 clippy lint 修在单独一次提交里,而不是偷偷塞进功能提交里;而且当一个并行会话中途踩了共享的 ~/.yolped/registry.json 时,它自己注意到并恢复了原来的条目。这是资深工程师的行为,不是自动补全。
结论:唯一一个我不用仔细重读就敢合并分支的模型。最便宜,设计还最好——差距明显,不用比。
Kimi K2.7-Code——代码不错,有真瑕疵,价格不对
doctor.rs(415 行): 干净诚实——它把密码认证标成"无法验证",而不是假装检查了,SSH 探测通过 channel 走 5 秒超时,而不是无限阻塞。但有两个瑕疵:它把 yolped.json 加载了两次(一次给配置检查,一次给依赖检查),而不是把解析好的配置传下去;更糟的是它总是 exit 0——打印一条红色的"部分检查失败"摘要,然后返回 Ok。一个 CI 没法拿它做门禁的诊断命令,等于丢了这个功能一半的意义。
rollback.rs(352 行): 扎实的活儿。DeployRecord 历史带 serde-default 迁移,重新部署前有 has_tag 防护,错误清晰,还对着自己起的本地 docker registry 验证过。就是比 GLM 的平淡些——没有列对齐、没有 newest 标记——而且同样的双加载毛病(registry 加载和 tag 检查各搞一次)。
结论:B+ 的工程,A+ 的价格。它写的任何东西都不会坑你,但 GLM 用五分之一的钱产出了更好的设计。
MiniMax M3.1-Flash——草图不错,就是落不了地
doctor.rs(566 行): 纸面上是这里最好的架构——四态检查(pass/fail/warn/skip)、对齐的摘要表、尊重 DOCKER_CONFIG 和 docker-credential helper,而且失败时确实 exit 非零(Kimi 没有)。如果整个评测只有任务 1,它会是竞争者,尽管为了到这一步烧了 GLM 4.6 倍的 token。
rollback:它从来没做出一个能用的。 会话显示它把 rollback.rs 完整写了两遍、加了个 compose 模块、设计了一个确实不错的 CLI(正确的 list/--to 冲突处理、TAG/IMAGE/PUSHED AT 表格)——然后就陷进 push.rs 的反复读-改-读循环里了。28 次文件读取对 GLM 的 7 次,22 分钟里只有 3 次 bash 调用:它在 rollback 的活上连一次 cargo build 都没跑过。没提交,没可交付的东西,花了 $0.313。
说句公道话:设计方向没问题。失败的根源不是理解力,是收敛不了——而一个你需要盯得这么紧的模型,实际成本远高于它的 token 价格。
底线
- 让我印象深的: GLM 的工程直觉(CI 可门禁的退出码、单独提交 lint、主动修复被踩的 registry),Kimi 对无法验证项的诚实,MiniMax 的检查分类法。
- 不足的地方: Kimi 的 doctor 永远 exit 0 和双份配置加载;MiniMax 停不下来重读、开始不了交付。
- 值不值? GLM-5.3-Flash:值——最好的设计质量和最低的成本在同一个包里;现在是我默认的便宜写码模型。Kimi K2.7-Code:不值,贵 5 倍——代码是好,但没好到 5 倍。MiniMax M3.1-Flash:不值——一个连多文件功能都做不完的模型,不是便宜模型,是昂贵的草稿生成器。