我用印地语提示词实测了 4 个 AI 视频生成器:Wan 3.0 vs Grok Imagine 1.5 vs Veo 3.1 vs Gemini Omni Flash
我用印地语提示词实测了 4 个 AI 视频生成器:Wan 3.0 vs Grok Imagine 1.5 vs Veo 3.1 vs Gemini Omni Flash
测试时间: 2026 年 10 月
使用场景: 印地语视频生成、短视频内容、AI 广告、基于参考图的视频制作
亲自实测的模型: 阿里 Wan 3.0、xAI Grok Imagine Video 1.5、Google Veo 3.1、Google Gemini Omni Flash
另外调研的模型: 字节跳动 Seedance 2.5、Kling 3.0、MiniMax H3、HappyHorse 1.1、Runway Gen-4.5、Luma Ray3.14、Pika 2.5
我为什么要测这些模型
AI 视频生成早就不只是做出几个视觉效果炸裂的五秒短片了。现在更值得琢磨的问题是:这些系统能不能稳定地产出能用的内容,能不能老实照着详细指令来,能不能保住参考图,能不能在英语以外的语言里生成自然的对话。
我尤其在意的是印地语。
对印度的商家和内容创作者来说,一个能用的模型光懂电影镜头词汇还不够。它得能处理本地口语、对话感、一眼就能认出来的环境、广告指令,最好还能应付方言口音。
我的目标,是搞清楚哪些模型在画质、生成成本、速度和可控性这几块组合起来最划算。
我花了时间亲自试了四个模型,翻了它们的文档和生成参数,还看了一些其他主流模型的对比。
我的初步结论:在我有限的实测对比里,Wan 3.0 效果最好,Grok Imagine Video 1.5 排第二。Veo 3.1 在我测试里最慢,对我这条特定提示词产出的结果也不是最强的。
这只是我实验里的一个观察,不是说 Wan 就全面更强。
测了哪些模型
| 模型 | 开发商 | 是否实测 | 主要定位 |
|---|---|---|---|
| Wan 3.0 | 阿里 | 是 | 多模态生成、更长片段、基于参考图的工作流 |
| Grok Imagine Video 1.5 | xAI | 是 | 快速视频生成、动作、集成音频 |
| Veo 3.1 | 是 | 电影级视频、音频、首末帧和参考图控制 | |
| Gemini Omni Flash | 是 | 快速生成、多模态输入、对话式编辑 | |
| Seedance 2.5 | 字节跳动 | 否 | 长叙事、参考图、多模态编辑 |
| Kling 3.0 | 快手 | 否 | 电影级动作、多模态生成、原生音频 |
| MiniMax H3 | MiniMax | 否 | 多模态生成、2K 视频、原生立体声 |
| HappyHorse 1.1 | 阿里云 | 否 | 文字、图片和参考图转视频 |
| Runway Gen-4.5 | Runway | 否 | 电影级控制、动作质量、指令遵循 |
| Ray3.14 | Luma | 否 | 图片动画、动作一致性、视频修改 |
| Pika 2.5 | Pika | 否 | 短视频创意和特效 |
下面各节会把我的实测发现和官方文档里写的能力分开来说。
我用的提示词
我用印地语指令来测这些模型,并且底层共用一条提示词,好让对比更有意义。
实验覆盖了三种生成模式:
- 文字转视频(Text-to-video): 根据一段文字描述生成视频。
- 图片转视频(Image-to-video): 让一张给定的图片动起来。
- 基于参考图的生成: 用视觉参考来引导生成结果。
目的就是看看不同模型面对大致相同的创意指令,各自会怎么理解。
原始印地语测试提示词
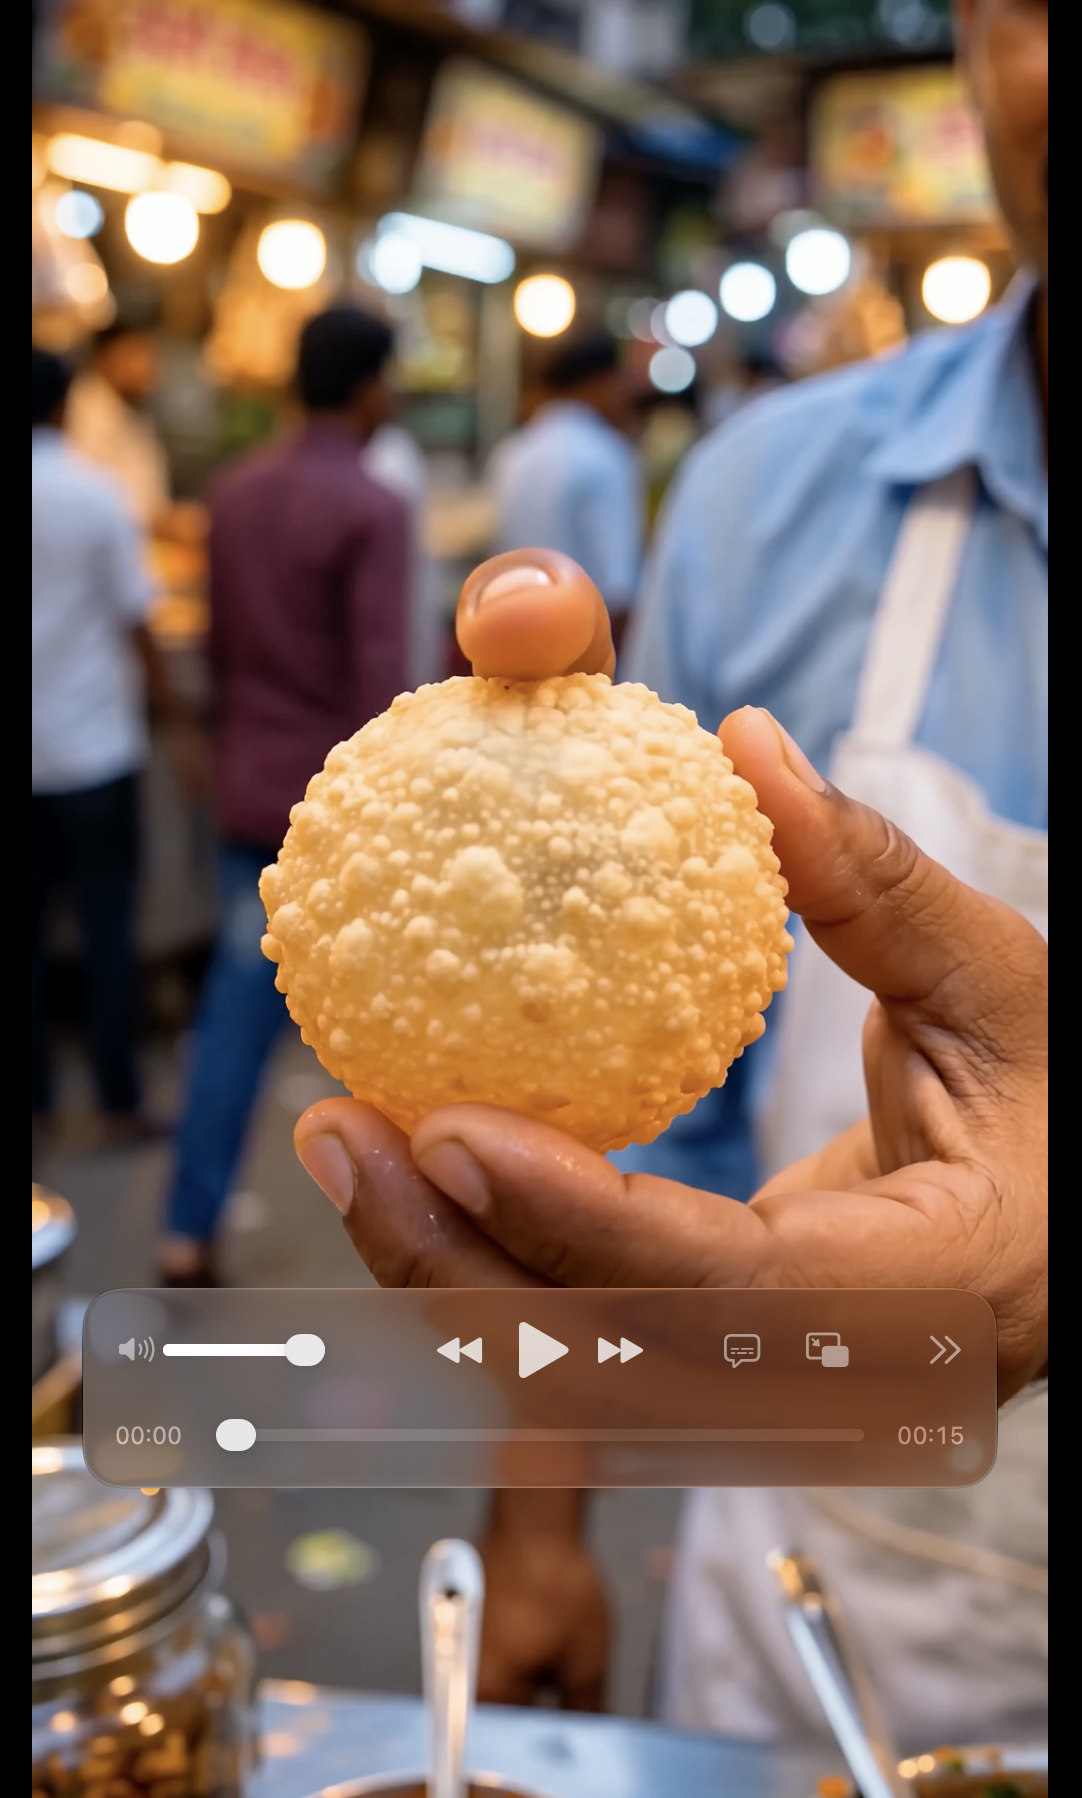
Use realistic human movements, authentic Indian street-food preparation, rich food textures, natural facial expressions, and professionally composed cinematic shots. ## Scene 1: The Craving (0-4 seconds) **Visuals:** Begin with an extreme close-up of a perfectly round, golden, crispy golgappa resting in the vendor's hand. The vendor gently cracks a hole in its top using his thumb. The camera slowly pushes forward as he scoops freshly mashed potato and chickpea filling into the golgappa. **Camera Motion:** Smooth macro push-in, shallow depth of field, subtle handheld realism. **Surroundings:** A busy Indian evening market, warm lights, softly blurred pedestrians and street-food stalls. **Hindi Voiceover:** "गोलगप्पे खाने का मन है? तो फिर इंतज़ार किस बात का?" **Audio:** Light upbeat Indian percussion begins, with subtle street-market ambience. ## Scene 2: The Flavor Explosion (4-8 seconds) **Visuals:** Cut to an ultra-close slow-motion shot of the vendor dipping the stuffed golgappa into a shiny steel bowl of vibrant green, spicy mint water. Tiny droplets splash naturally as the golgappa fills. Show detailed textures of crispy puri, spicy potato mixture, green coriander, and glossy tamarind chutney. The vendor lifts the overflowing golgappa toward the camera. **Camera Motion:** Macro tracking shot following the vendor's hand, brief slow-motion water splash, smooth focus pull from filling to golgappa. **Lighting:** Warm natural highlights, rich appetizing food colors. **Hindi Voiceover:** "करारे गोलगप्पे, चटपटा मसाला और ऐसा तीखा-मीठा पानी कि दिल खुश हो जाए!" **Audio:** Crisp water splash with a subtle musical accent. ## Scene 3: The Happy Customer (8-12 seconds) **Visuals:** Cut to a young Indian woman in her mid-20s standing beside the stall, smiling as the vendor serves her a fresh golgappa on a small disposable leaf bowl. She eats the golgappa in one bite, reacts naturally to the burst of spicy, tangy flavor, smiles with delight, and gestures enthusiastically for another. Her friends laugh and smile in the background. **Camera Motion:** Medium close-up transitioning into a gentle handheld tracking shot. Capture genuine facial expressions without exaggerated acting. **Hindi Voiceover:** "एक खाओगे, तो बार-बार खाने आओगे!" **Audio:** Satisfying crispy crunch, subtle laughter, lively background music. ## Scene 4: The Call to Action (12-15 seconds) **Visuals:** Cut to an appealing hero shot of five freshly prepared golden golgappas arranged neatly on a traditional Indian serving plate, accompanied by small bowls of vibrant green spicy water and dark brown tamarind chutney. The camera smoothly pulls backward, revealing the cheerful vendor standing behind his busy, colorful golgappa stall. He smiles and presents the plate toward the viewer with an inviting gesture. Finish with a clean hero frame suitable for placing the shop's name and location as an overlay. **Camera Motion:** Smooth cinematic pull-back, ending on a stable composition. **Hindi Voiceover:** "तो आज ही आइए [दुकान का नाम] पर! स्वाद ऐसा, जो याद रह जाए!" **Audio:** Upbeat musical finish, natural market ambience. ## Audio and Voice Direction - Use one consistent, lively Indian male Hindi voiceover throughout. - Native, conversational Hindi pronunciation with the energy of a professional Indian street-food advertisement. - Deliver the dialogue briskly and enthusiastically, with minimal pauses, to fit 15 seconds. - The narrator is off-camera, so no lip-sync animation is required. - Maintain consistent background music and street ambience across all scenes. - Synchronize the sounds of cracking puri, pouring pani, and crunchy bites with the visuals. - Keep dialogue clearly audible above music and ambient noise. ## Visual Consistency and Quality Requirements - Photorealistic 4K-quality detail with natural motion at 24 fps. - Maintain the same vendor, stall, clothing, lighting, and general surroundings across cuts. - Golgappas must look authentic to Indian street food, not generic spherical snacks. - Physically realistic hands, utensils, water splashes, eating actions, and facial expressions. - Vibrant, appetizing colors without excessive saturation. - Avoid distorted fingers, unnatural mouth movements, floating objects, flickering, changing stall designs, and artificial-looking faces. - No subtitles, random text, watermarks, brand logos, or unwanted graphics. - Preserve a continuous, professionally mixed audio bed through every camera cut. **Final Objective:** Create a visually irresistible, authentic Indian street-food advertisement that makes viewers immediately crave golgappas and want to visit the featured stall. ## Photorealism, Human Authenticity & Scene Consistency **Critical Requirement:** The entire video must look like authentic live-action footage filmed with a professional cinema camera in a real Indian street market, not AI-generated content. **Human Realism:** - Every person must appear indistinguishable from a real human, with natural Indian facial features, realistic skin pigmentation, visible pores, fine facial hair, subtle wrinkles, and authentic skin texture. - Preserve natural facial asymmetry, realistic eye reflections, believable teeth, and detailed hair strands. - Human expressions, blinking, breathing, chewing, and gestures must follow natural anatomical movements. - Avoid overly smooth, plastic-like skin, artificial beauty filters, exaggerated expressions, uncanny faces, and robotic movements. **Scene, Environment & Surface Textures:** - Maintain physically accurate textures on stainless-steel utensils, glass jars, clothing, food, countertops, and surrounding buildings. - Include realistic environmental imperfections such as subtle dust, fabric wrinkles, water droplets, fingerprints on steel surfaces, and natural wear on the stall. - Ensure accurate contact shadows, ambient occlusion, realistic reflections, and consistent light direction across all shots. - Background pedestrians must move naturally, with realistic crowd behavior, proper depth perception, and no duplicated or morphing faces. - All objects must maintain consistent shape, size, position, and material properties throughout the video. **Camera & Cinematography Realism:** - Simulate genuine optical characteristics of a professional cinema camera, including natural depth of field, realistic motion blur, subtle lens imperfections, and physically accurate exposure. - Use subtle handheld camera micro-movements rather than perfectly artificial floating camera motion. - Maintain accurate perspective, believable focal lengths, and natural transitions between foreground and background. - Preserve temporal consistency between frames, especially for faces, hands, clothing, food textures, and moving objects. - No frame flickering, texture crawling, face morphing, object deformation, or inconsistent shadows. **Food & Physical Interaction Realism:** - Golgappas must have naturally uneven, porous, crispy surfaces rather than perfectly smooth spherical shells. - Show believable finger pressure while cracking the puri, authentic filling movements, realistic water displacement, and physically accurate liquid splashes. - Ensure hands interact correctly with utensils and food, with realistic finger articulation and grip. - Eating and chewing actions must look completely natural, without unnatural mouth deformation. **Final Quality Standard:** The finished video should resemble a professionally shot Indian street-food commercial captured on location with real actors, real food, authentic surroundings, and natural lighting. Prioritize human believability, physical accuracy, texture fidelity, and frame-to-frame consistency over exaggerated cinematic effects. It should never resemble a 3D render, animation, synthetic advertisement, or AI-generated video.
我建议直接用原始提示词,而不是凭记忆重写。对话、镜头指令、场景构图这些细节差一点点,结果可能就差很多。
一条用于可复现测试的后续提示词
下面这条是我建议的基准提示词,不是我最初实验里用的那一条原文。
Create a realistic 15-second vertical advertisement
for an Indian sweets shop.

Scene: A modern but authentic Indian mithai shop
during the festive season.

Character: A young Indian shopkeeper speaking
directly to the camera.

Dialogue (Hindi):
"इस त्योहार, मिठास हो कुछ खास!
हमारी दुकान पर आइए और अपनों के साथ
खुशियां बांटिए।"

Camera: Medium shot, slow cinematic push-in.

Lighting: Warm festive lighting, natural skin tones.

Requirements:
- Natural Indian Hindi pronunciation
- Accurate lip synchronization
- Consistent character appearance
- Realistic facial expressions
- No unintended subtitles or extra dialogue
- Preserve the appearance of supplied reference images
- 9:16 aspect ratio
它适合在更受控的条件下评测模型。
任务与结果
任务 1:文字转视频
目标: 看哪个模型能把一条印地语创意提示词变成一段像样的短视频。
我在各个模型上用了同一个提示词概念,然后对比它们生成的结果。
Wan 3.0
Wan 3.0 产出了我这次实验里最满意的结果。
对我正在测的这个具体创意方向来说,它的输出整体最有说服力。
比较突出的一点是:虽然各模型可选的生成选项和分辨率并不完全一样,但我还是更喜欢它最终生成的那条视频。
从工程角度看,阿里的文档也让 Wan 很有意思。Wan 3.0 的 API 支持最长 30 秒的生成时长,分辨率可选 480p、720p、1080p,还支持参考音频,以及好几种基于图片的生成工作流。
能不能生成更长片段,对广告特别重要——广告往往需要开场、产品镜头、对话和收尾。
我的评价: 在我初步实测里输出最好,是我下一轮进一步实验的第一候选。
Grok Imagine Video 1.5
Grok Imagine 在我的测试里排第二。
它的输出已经够有竞争力了,所以我会把它留到下一轮评测里,而不是不测就直接选 Wan。
xAI 的 Video 1.5 文档说它在动作、物理、音频生成和同步上都有改进。
目前的 API 也支持文字转视频、图片转视频、基于参考图的控制,以及最高 1080p 的视频生成。
Grok 一个有意思的优势是它偏 API 化的工作流。它通过异步请求来出生成结果,很适合那种提交任务、再回来取结果的程序化流水线。
我的评价: Wan 的有力替代品,尤其是在生成速度和程序化集成比较重要的时候,值得拿来当基准。
Google Veo 3.1
Veo 3.1 是最让我失望的一个,跟我的预期差得有点远。
在我对比的输出里,它生成最慢,而且就这条特定提示词而言,出来的视频不如 Wan 和 Grok。
但这并不是对 Veo 画质的整体结论。
Veo 支持原生音频生成、参考图、首帧/末帧控制,还有 4K 输出。它还有 Standard、Fast、Lite 三个版本,价格和性能差异很大。
还有个额外的坑是语言支持。Google 的 Vertex AI 文档里写着 Veo 3.1 支持的提示词语言是英语。因为我全程用印地语做实验,这可能会影响对比结果。
更公平的后续测试,应该用同一条印地语对话分别试两种方式:全印地语提示词,以及「英文场景描述 + 印地语对话指令」。
我的评价: 技术上很强,但在我这个只有印地语的初步实验里不算最合适。没测别的提示词和版本之前,我不会把它排除掉。
Gemini Omni Flash
我还试了 Google 的 Gemini Omni Flash。
它的设计挺有意思:把视频生成和对话式编辑结合在了一起。
它不把每次生成当成一个孤立的请求,而是能支持迭代式指令,比如调整镜头、延长场景、或者修改现有视频。
Google 的 Gemini Omni 1.1 Flash 文档说它支持文字、图片、音频、视频作为输入,还支持视频延长和关键帧插值。
我没收集到足够标准化的对比证据,没法给 Omni Flash 排一个相对 Wan、Grok 和 Veo 的可靠名次。
我的评价: 在迭代式编辑和制作流程上值得再挖一挖,但我这有限的测试给不出确定的画质排名。
任务 2:图片转视频
目标: 搞清楚这些模型在让现有视觉素材动起来这件事上做得怎么样。
这个很重要,因为生产环境的内容很少是从一张白纸的提示词开始的。
一个真实的广告工作流,可能已经有产品照片、店面图、角色参考,或者已经定稿的品牌素材。
一个能用的图片转视频模型,应该保住输入里那些关键部分,而不是凭空捏出一个完全不同的场景。
我把图片驱动的生成纳入了测试,但没单独记录足够多的结果,没法专门就「图片保真度」给每个模型排名。
要做更正式的实验,我会评测:
- 产品形象和颜色保真度
- 人脸和角色外观的稳定性
- 要求的动作是否准确
- 镜头运动和场景连贯性
- 参考素材是否出现多余的变形或被改动
对商业内容来说,「做出来好看」和「做出来准确」是两码事,这个区别极其重要。
一条视觉上再惊艳的生成广告,只要产品已经不像真产品了,那它就是失败的。
任务 3:基于参考图的生成
目标: 看看参考输入能怎么帮我们控制输出。
基于参考图的生成,对需要可复现的创意生产特别有意思。
想象一下给同一家店生成十条广告。每条视频的脚本、地点、镜头运动可能都不一样,但品牌形象和角色应该保持一致。
我探索了基于参考图的工作流,也研究了现有 API 参数和提示词指南。
Wan 的生成控制尤其值得研究,文档帮我搞清楚了它的输入怎么放进更大的内容生成流水线里。
我的实验规模太小,没法得出一个可靠的跨模型「身份一致性」分数。
不过,参考图保真度是我在生产评测里会最先测的东西之一,因为它直接影响后面需要多少人工修正。
任务 4:印地语和地区语言的适配度
目标: 专门评估面向「印地语优先」创意内容的视频生成,而不是只依赖英文演示。
我所有的实测都用的是印地语提示词。
这是刻意的。
大多数视频模型的公开演示都集中在英文指令、电影级风景、动作场面,或者视觉冲击力强的场景上。
对印度市场来说,还有一些额外的问题:
- 模型听得懂印地语创意指令吗?
- 能生成自然的对话吗?
- 说出来的对话跟要求说的词一致吗?
- 嘴型跟语音对得上吗?
- 能处理印度发音和本地文化语境吗?
- 指令里英文印地语混着来,表现会变吗?
我没能跨多条印地语提示词、地区语言和口音做系统性的评估。
所以我没法断言哪个模型在印地语语音生成上就是最好的。
我初步偏向 Wan,反映的是我生成的那些样本的整体输出质量,而不是一个经过测量的印地语语音准确度基准。
成本:我实际观察到的
画质很重要,但当你反复生成内容时,成本就会变成一个关键因素。
下面是我实验期间记录的近似生成成本。
| 模型 | 视频时长 | 分辨率 | 观察到的近似成本 | 每秒成本 |
|---|---|---|---|---|
| Wan 3.0 | 15 秒 | 1080p | $3.00 | $0.20 |
| Grok Imagine 1.5 | 15 秒 | 480p | $2.20 | $0.147 |
| Veo 3.1 | 8 秒 | 4K | $2.50 | $0.313 |
这些是我测试时的近似数字,不是对官方 API 价格的标准化对比。它们可能反映了我用的特定平台、配置或计费方式。
官方 API 定价核对
我也查了当前各家提供商的文档,搞清楚底层经济账。
| 模型 / 版本 | 官方 API 单价 | 示例输出成本 |
|---|---|---|
| Wan 3.0,1080p,新加坡 | $0.20/秒 | 15 秒 $3.00 |
| Grok Imagine Video 1.5,480p | $0.08/秒 | 15 秒 $1.20 |
| Grok Imagine Video 1.5,720p | $0.14/秒 | 15 秒 $2.10 |
| Veo 3.1 Standard,4K | $0.60/秒 | 8 秒 $4.80 |
| Veo 3.1 Fast,4K | $0.30/秒 | 8 秒 $2.40 |
| Gemini Omni Flash,720p | 约 $0.10/秒 | 10 秒约 $1.00 |
观察到的价格和官方定价之间有出入,正好说明为什么要记录提供商、模型版本、分辨率和计费方式。
尤其是我那个 $2.20 的 Grok 近似数字,跟 xAI 官方公布的 480p Video 1.5 基础价对不上。同理,Veo 的近似数字更接近 Google 的 Fast 4K 价,而不是 Standard 4K 价。
输入素材费、提供商加价、配置差异,也会影响最终价格。
关键点在于:当分辨率、视频时长和模型版本都不一样时,报价是没法直接横向比较的。
真正的生产指标:每条可用视频的成本
原始生成成本只是等式的一边。
假设一个模型每次生成 3。
如果便宜的那个要试好几次才能出个能用的结果,那它未必更划算。
更好的指标是:
Cost per usable video =
Total generation spend /
Number of outputs accepted for use
举一个假设的例子:
| 模型 | 每次尝试成本 | 尝试次数 | 被采用的输出 | 每条被采用视频的成本 |
|---|---|---|---|---|
| 模型 A | $2.00 | 10 | 3 | $6.67 |
| 模型 B | $3.00 | 10 | 8 | $3.75 |
这些是示例数字,不是我实验测出来的结果。
它们想说明的是:生产团队应该优化「成功的输出」,而不是单纯把一次 API 请求的价格压到最低。
我还调研过的其他模型
除了自己亲测的四个,我也把目光放到更广的市场,看看大方向在哪。
下面的发现来自模型文档、官方公告和第三方对比,而不是我自己生成的片段。
1. 字节跳动 Seedance 2.5
Seedance 2.5 是我最想试的模型之一。
字节跳动在 2026 年 7 月正式发布了它,主打更长的视频生成、多模态参考和更强的编辑控制。
按它的文档,Seedance 2.5 支持:
- 单次生成最长 30 秒的片段
- 多轮视频延长
- 最多 30 张参考图
- 最多 10 段参考视频和 10 段参考音频
- 时间戳级别的编辑控制
- 音视频联合生成
这些能力对更复杂的广告和故事来说很有吸引力。
比如,一个创意工作流可能涉及产品的多张参考图、某种特定视觉风格、一段给定的音频参考,再加上一条「跨多个镜头保持一致」的指令。
与其一个场景一个场景地单独生成,更丰富的参考控制能帮这些元素协调起来。
在我看过的第三方模型对比里,Seedance 2.5 表现也相当亮眼。
不过我没自己生成 Seedance 2.5 的片段,因为要测它还得再充额度,而我已经在别的实验上花过钱了。
调研评估: 我下一轮受控对比里最有力的候选之一,尤其是跟 Wan 3.0 对打。
2. Kling AI 3.0
Kling 3.0 是快手在 2026 年 2 月发布的。
这个版本在一致性、电影级输出、原生音频和多模态输入上都有改进。
快手的公告里说它支持最长 15 秒的视频,还支持多语言对话、口音和方言。
Kling 也提供多种涉及文字、图片、音频、视频的生成和编辑工作流。
Kling 最吸引我的,是电影级控制和语音生成这两者的潜在组合。
对广告来说,很值得测一测:一个模型能不能稳定地拍出好看的镜头,又不丢掉对话准确性。
多语言的说法跟印度内容相关,但我没亲自验证过它印地语或地区语言的实际表现。
调研评估: 电影级内容上是个认真的竞争者,但印地语对话质量需要直接测。
3. MiniMax H3
MiniMax H3 从工程和成本角度看特别有意思。
H3 发布于 2026 年 7 月,支持多模态输入,生成带原生立体声的视频。
它官方公布的能力包括:
- 最长 15 秒视频
- 最高 2K 分辨率
- 文字、图片、视频、音频输入
- 视频编辑和动作迁移
- 多模态参考条件控制
MiniMax 还在 2026 年 8 月宣布开源 H3。
这对想要更大地控制部署、定制或基础设施的开发者很有吸引力——当然要受官方许可和硬件要求的约束。
MiniMax 的发布资料把 H3 定位为适合广告、电商、产品设计和其他商业工作流。
调研评估: 我会把它加进下一轮基准,尤其是在评估性价比和部署灵活性的时候。
4. 阿里 HappyHorse 1.1
HappyHorse 是通过阿里云能用的另一个有意思的选项。
它支持文字转视频、图片转视频和基于参考图的生成。
1.1 版本的文字转视频支持最长 15 秒、1080p 输出。
阿里公布的新加坡区 HappyHorse 1.1(1080p)价格是 2.70。
这跟 Wan 3.0 在相同地区、相同时长、相同分辨率下的官方定价很接近。
不过,分辨率一样、价格差不多,不代表生成质量也一样。
调研评估: 值得跟 Wan 直接对比一下,尤其是用完全相同的参考图和印地语指令。
5. Runway Gen-4.5
Runway Gen-4.5 非常看重动作质量、视觉保真度和指令遵循。
Runway 的文档说它在复杂场景构图、精细的镜头编排和真实物理运动上是强项。
它支持文字转视频和图片转视频,按文档里的工作流,单次生成最长 10 秒。
目前 Runway 的 API 把 Gen-4.5 标为 12 credits/秒,每个 credit 定价 0.12/秒。
Runway 对那种更看重受控视觉镜头、而不是长对话序列的工作流特别合适。
调研评估: 产品电影感、风格化内容和镜头控制实验上的强力候选。
6. Luma Ray3.14
Luma 的 Ray3.14 主打动作一致性、高分辨率输出和视频修改。
它官方公告强调原生 1080p 生成、对指令遵循的改进,以及相比 Ray3 更高的效率。
这个模型也支持视频修改工作流——这在「改现有镜头」而不是「从零生成新镜头」的场景里会很有用。
一个重要的限制是,Ray3.14 不支持角色参考,不像一些面向参考图的竞品模型那样。
调研评估: 在视觉细化和图片动画上可能有用,但如果是重度依赖参考图的角色一致性,它未必是我的首选。
7. Pika 2.5
Pika 2.5 是另一个值得在短视频创意生成上探索的模型。
Pika 的生态强调易上手的创意工作流和特效。
我会优先把它用在社交媒体创意概念、转场和风格化实验上,而不是假设它能在复杂广告指令上干过那些可控性更强的模型。
调研评估: 在社交优先的创意内容上有点意思。但在判断它的画质或性价比之前,我需要亲自上手测。
Sora 2 呢?
Sora 2 曾经是个重要的视频生成模型,值得在历史上记一笔。
不过,OpenAI 在 2026 年 4 月 26 日停掉了 Sora 的网页端和 App 体验,2026 年 9 月 24 日又停掉了它的 API。
所以在 2026 年 10 月,它已经不适合作为新的生产集成了。
关于提示词,我学到了什么
在生成之外,我还翻了 API 文档、支持的参数、提示词指南和提示词优化资源,尤其是 Wan 3.0 的。
一个有用的经验是:视频提示词光靠一段简单的文字描述是不够的,多点结构会更好。
一条好的提示词,应该把几个关注点明确拆开。
场景构图: 画面里应该出现什么,环境长什么样,哪些东西必须保持不变。
主体行为: 每个人或物体该做什么,包括手势、动作和互动。
镜头方向: 场景是固定镜头、摇镜、跟拍,还是缓慢推近。
音频方向: 准确的对话、语言、环境声,以及想要的语气呈现。
约束条件: 系统应该避免改动什么,比如产品外观、品牌颜色、参考形象。
时间: 在有限的秒数内,需要发生什么。
对印地语视频,我还会试不同的提示词语言策略。
全印地语的提示词,可能跟「英文场景指令 + 印地语对话」表现不同。
同理,给一段参考语音,跟完全靠模型从文字生成语音,结果也可能不一样。
这些都是值得测的假设,而不是我目前样本能确定的结论。
我推荐的下一轮基准
如果要把这次探索变成一个更严谨的评测,我会从 Wan 3.0、Seedance 2.5、Grok Imagine 1.5、Kling 3.0 和 MiniMax H3 开始。
我会在所有模型上用相同的创意概念和支持性参考图,并尽量对齐输出配置。
建议的评测框架
| 维度 | 权重 | 我会测什么 |
|---|---|---|
| 视觉质量 | 20% | 真实感、伪影、视觉一致性 |
| 印地语对话 | 20% | 语音准确度、自然度、发音 |
| 指令遵循 | 20% | 要求的动作和约束是否被遵守 |
| 参考图保真度 | 15% | 角色、产品和品牌一致性 |
| 音画同步 | 10% | 语音、嘴型和动作之间的对齐 |
| 成本与延迟 | 15% | 成功输出的经济账和端到端生成时间 |
这些权重只是一个提议的评测框架,不是给模型打的分。
每个模型我会至少生成五次,并测几个不同的创意场景。
比起从一两次生成里挑最强的那条,这样能更好地估算一致性和失败率。
我还会记录:
model_name
model_version
provider
prompt
prompt_language
generation_mode
reference_assets
duration_seconds
resolution
audio_enabled
seed_if_available
generation_latency
actual_cost
human_quality_score
dialogue_accuracy
accepted_for_use
failure_reason
这样更容易复现结果,也更容易理解某个模型为什么被选中。
对生产环境的内容生成系统,我还会研究「不同创意任务用不同模型」,而不是只依赖单一提供商。
一个对话很牛的模型,未必是产品 B-roll 最便宜或最可靠的选择;而那个电影感最强的模型,参考图保真度可能不如另一个。
我测试的局限
这是一次探索性对比,不是全面基准。
有几个局限值得说清楚:
- 生成次数有限: 我没对每个模型跑大量重复测试。
- 输出配置不同: 一些价格和画质对比涉及不同的分辨率和时长。
- 只有印地语实验: 我没做对等的英文测试,没法确认提示词语言会不会改变排名。
- 没有正式的语音评估: 我没计算转录错误率、口型同步准确度或说话人相似度。
- 没有 Seedance 2.5 的实测结果: 我对 Seedance、Kling 和其他调研模型的看法来自公开资料,而不是我自己的生成。
这些局限很重要,因为视频生成对提示词、参考素材、输出设置和生成随机性都很敏感。
一个模型可能生成一次很漂亮的样本,但重复跑起来可靠性很差。
结论:哪个 AI 视频模型值得用?
让我印象深刻的地方
Wan 3.0: 实测模型里我最喜欢的。它的输出让它成了下一轮实验的头号候选。
Grok Imagine Video 1.5: 一个有竞争力的替代选项,值得更多评测,尤其是在实际 API 生成上。
Gemini Omni Flash: 它的对话式编辑思路,对需要反复创意修改的工作流可能很有价值。
Seedance 2.5: 官方公布的参考图和编辑能力,让它对更复杂的内容制作特别有吸引力,尽管我还没直接测过。
不太给力的地方
Veo 3.1: 在我初步实验里,它生成最慢,就我用的提示词而言结果也不是最好的。这也可能受它的配置和我用印地语指令的影响。
成本可比性: 不同分辨率、时长、版本和提供商之间价格差异很大。拿一条片段的价格跟另一条比,可能会误导。
基准一致性: 单次跑出来的好看输出,说明不了生产环境下的稳定表现。
值不值得用?
Wan 3.0:值,基于我有限的实测经验。 它是我接下来第一个想进一步测的模型。
Grok Imagine Video 1.5:值,作为备选。 我会把它留在候选名单里,而不是只做一个排他选择。
Veo 3.1:对我测的那条特定印地语提示词来说,不是我的首选。 它值得用更可比的配置和它不同的版本单独评估一次。
Seedance 2.5:有潜力,但还没亲自验证。 它是我这次实验里缺席的最重要模型之一。
最后的总结
我最大的体会是:评测 AI 视频模型,得看超过那些炫酷演示片段之外的东西。
对实际落地来说,真正重要的问题是:
这个模型能不能照着创意简报走?能不能保住参考图?能不能生成自然的印地语对话?它多常会失败?一条真正能用的视频到底要花多少钱?
在这个有限的实验里,Wan 3.0 是我的赢家,Grok Imagine 1.5 紧随其后。
但最有用的下一步,是 Wan 3.0 和 Seedance 2.5 之间一次受控的「印地语优先」对比,最好再把评测扩展到 Grok、Kling 和 MiniMax H3。
我更愿意选一个能以可预测成本稳定产出「可上线视频」的模型,而不是一个偶尔冒出一条惊艳演示的模型。
来源和进一步阅读
上面的实测发现来自我自己的实验。技术规格和调研模型的对比,核对了以下来源:
- 阿里云 - Wan 3.0 文档
- xAI - Grok Imagine Video 1.5 公告
- xAI - Grok Imagine Video 1.5 API 定价
- Google - Veo 3.1 文档
- Google - Gemini API 定价
- Google - Gemini Omni Flash 文档
- 字节跳动 - 介绍 Seedance 2.5
- 快手 - Kling 3.0 发布
- MiniMax - H3 技术公告
- Runway - Gen-4.5
- Luma - Ray3.14
- Artificial Analysis - 视频生成排行榜
- OpenAI - Sora 停用
声明: 没有模型提供商赞助这篇评测。亲自测的模型只通过有限数量的印地语生成来评估,所有没测过的模型都明确标注为仅调研对比。