编码开源Qwen 3.8Claude
Qwen3.8 家族成了我的新心头好
95% 有帮助5% 没帮助
我在 ohmypi(omp)里跑了一次真实的构建:qwen3.8-max 当编排者,qwen3.8-flash 当执行者。下面是那次会话里发生的事,以及会话记录下来的数字。我跟 Claude 的对比只是大致印象,不是这次单次运行测出来的。
测试的模型
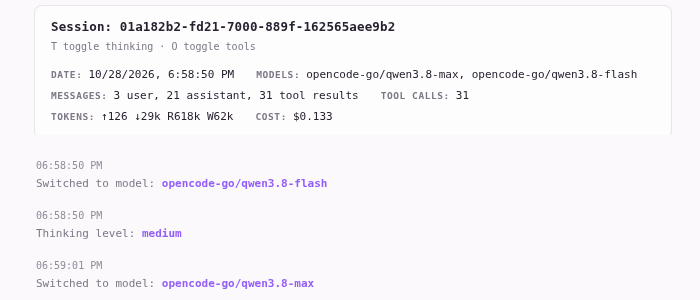
- 模型:qwen3.8-max(规划/编排)和 qwen3.8-flash(执行),通过 ohmypi(omp)跑。会话里把它们记作 opencode-go/qwen3.8-max 和 opencode-go/qwen3.8-flash。
- 使用场景:写代码——在一个小型 Python CLI 上做规划者/执行者分工
我用的提示词
提示词 1,发给 qwen3.8-max(原文照录):
你是编排者。不要写代码、不要建文件、也不要跑命令。为一个单独的执行者模型产出一份实现计划。

项目:构建一个 Python 3 CLI 工具,叫 merge_csv.py,放在一个叫 dedupe-csv 的新文件夹里。只用标准库,不联网、不加额外包。

需求:
- 用法:python merge_csv.py INPUT_DIR OUTPUT_FILE
- 按字母顺序读取 .csv 文件。把 OUTPUT_FILE 从输入里排除,这样重复运行时不会把自家输出又吞进去。
- 第一个非空文件定表头。跳过表头不同的文件,并打印一条警告,点明每个被跳过的文件。
- 当每一列在去除首尾空白、忽略大小写后都一致时,就算重复行。保留第一行的原始值。
- 正确处理带引号的逗号和 Unicode。
- 输入文件夹为空时,成功退出并给一条清晰提示,不生成输出文件。
- 打印合并了多少文件、跳过了多少、从匹配表头的文件里读了多少数据行、去掉了多少重复。

给执行者的交付物:merge_csv.py、用 unittest 写的 test_merge_csv.py、一份简短 README,还有 samples/ 里的示例 CSV。

产出一份执行者可以直接用的计划,包含:
1. 编号的小实现步骤。每一步:动了哪些文件、要实现什么、依赖前面哪些步骤、怎么验证。
2. 具体的测试夹具和期望输出,从需求里推出来。覆盖跨文件重复、大小写/空白差异、表头不匹配、空文件夹、带引号的逗号、Unicode、确定性顺序,以及把输出文件放进输入文件夹里再跑一次。
3. 任何还没定的边界情况以及你选择的处理方式,这样执行者就不用自己瞎猜。
4. 执行者跑测试和做 CLI 演示该用的确切命令。把期望结果明确标成"期望",而不是"观察到的结果"。
5. 一份最终验收清单,再加一个复查步骤:找有没有漏掉的边界情况,需要的话补一条回归测试,然后重跑所有测试。

计划要实用、具体。只输出计划,不要实现。
提示词 2,发给 qwen3.8-max:把这份计划输出到 plans/ 目录里
提示词 3,发给 qwen3.8-flash(切换模型之后):现在就执行计划
任务与结果
任务 1 - 规划/编排(qwen3.8-max)
- 输入:上面那段规划提示词。不写代码、不跑命令,只要计划。
- 输出:大约两分钟产出一份 15.7 KB 的计划。里面有 10 个带顺序的步骤,每步都标了文件、依赖和检查点;8 个测试夹具(F1-F8);12 个提前定好的边界决策(E1-E12);确切的命令,还有验收清单。我让它写的时候,它写进了
plans/merge-csv-plan.md。Max 用了 3 轮、8,935 个输出 token。 - 露馅的地方:计划里"读取数据行数"的期望数字在两个夹具上算错了(它写 5 和 3,按需求应该是 6 和 4)。它还排错了示例文件的顺序,让表头不对的文件排到了最前面。
任务 2 - 执行(qwen3.8-flash)
- 输入:
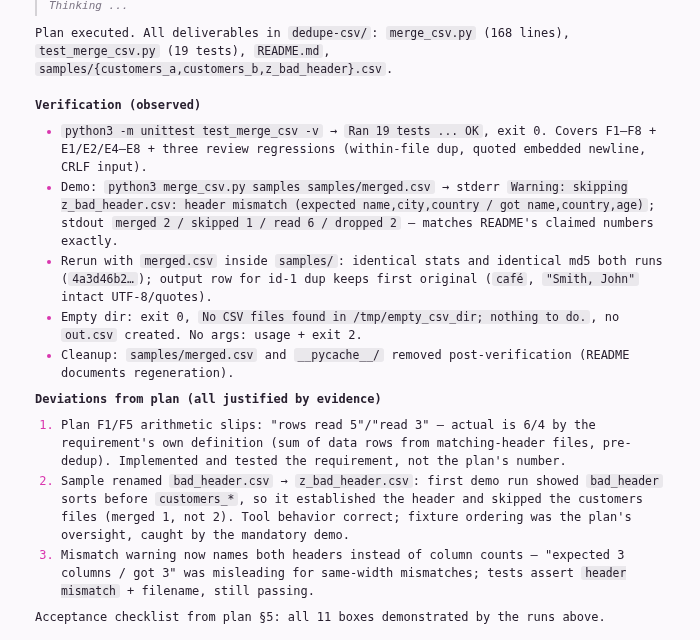
现在就执行计划,选的是 flash。它跑了大概六分钟,18 轮、30 次工具调用(整场会话是 31 次)。 - 输出:
merge_csv.py(168 行)、test_merge_csv.py、一份 README 和三个示例 CSV。第一次跑测试是 16 个用例,2 个失败、1 个报错。其中一个失败来自计划里写错的行数。Flash 对照需求检查了一下,把测试改了,没有照抄计划里的数字。另外两个是它自己测试辅助函数里的 bug 和一个空行夹具,都在下一次编辑里修好了。 - 第一次演示运行合并了 1 个文件而不是 2 个。那个表头不对的示例排在客户文件前面,所以它定了表头,正常文件反而被跳过了。Flash 发现了,把文件改名成
z_bad_header.csv重跑了一遍。它还把表头不匹配的警告从"期望 3 列 / 得到 3 列"改成了点出两个表头分别是什么,因为原来的文案对两个列数相同的文件来说根本讲不通。 - 复查环节:它加了 3 个回归测试(单个文件内的重复、带引号的嵌入换行、CRLF 输入)。最终运行:19 个测试全部通过。演示输出:合并 2 个文件、跳过 1 个、读入 6 行、去掉 2 个重复。把输出文件放进输入文件夹里再跑一次,两次的统计一样、md5 也一样。空文件夹退出码 0,给一条清晰提示,不生成输出文件。
- 一个小踉跄:一次 todo 调用把任务名搞乱了、报了一次错。它重试了一下就接着干了。
成本
这些是 omp 给这次会话记录的总数。每类成本是会话文件里每一轮数字的加总。
| 项目 | 成本 |
|---|---|
| 输入 token(126,未命中缓存) | $0.0001 |
| 输出 token(28,789) | $0.0629 |
| 缓存读取(617,750 token) | $0.0153 |
| 缓存写入(61,747 token) | $0.0543 |
| 总计 | $0.1326 |
按模型分:
| 模型 | 轮数 | 输出 token | 成本 |
|---|---|---|---|
| qwen3.8-max | 3 | 8,935 | $0.1050 |
| qwen3.8-flash | 18 | 19,854 | $0.0276 |
Max 3 轮就花掉了总成本的约 79%。Flash 跑了 18 轮,成本大概是 max 的四分之一。
我的真实评价
- 让我印象深的:这个分工在真实任务上确实干活了。Max 的计划详细到 flash 能在同一场会话里把工具、一个 19 测试的套件和 README 都做出来,总共约 $0.13,端到端大概 10 分钟。Flash 没有盲目照抄计划。当测试跟计划的算数对不上时,它回头去看需求,还靠跑演示发现了示例排序的问题。omp 里这套编排者+执行者的设置,正是我想要的效果。
- 不足的地方:max 的计划里有两个算错的期望数字、一个示例文件排序错误,这俩都得靠 flash 兜底。Flash 第一次跑测试也有 3 个失败,其中一个来自它自己辅助函数里的 bug。最终检查是过了,但计划第一次写出来并不干净。
- 值不值? 值——因为花 $0.13 就从这套设置里拿到了一个 19 个测试全过的工具,而且计划里的错是靠跑代码抓出来的,不是我抓的。这只是一个很小的 Python 任务,所以我不说它总体上能碾压谁。我的整体印象是,qwen3.8 的 max 和 flash 通过 omp 跑,对我干活的方式来说跟 Claude 一样够用,但这场会话没有验证这一点,我也没有逐行审代码。