我为什么从 Claude Opus 换到 GPT-6 Sol:token 经济学才是关键
测试模型
- 模型: OpenAI GPT-6 Sol vs Anthropic Claude Opus
- 场景: 写代码、后端开发、调试,还有 AI agent 工作流
- 主要评测标准: 结果质量相对于 token 消耗和成本
我为啥更爱用 GPT-6 Sol
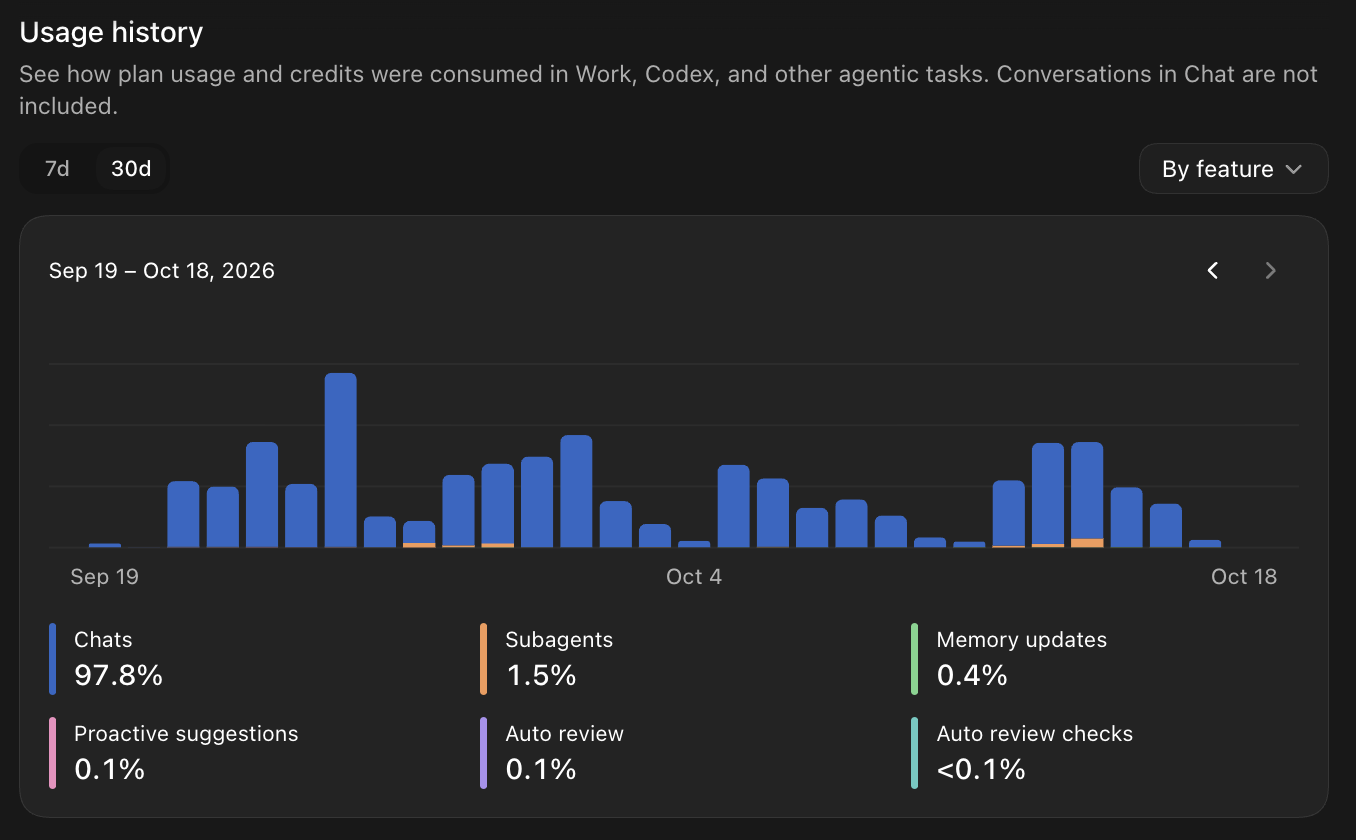
GPT-6 Sol 和 Claude Opus 我都在用,做软件工程和 AI 开发。两个模型都挺能打的,但我越来越发现自己选 GPT-6 Sol,就为一个很实际的原因:Claude Opus 让我花的 token 更多,而且我没看到足够多的额外价值来为日常工作的这笔开销买单。
在写生产代码的时候,一个 AI 模型的成本不只是一次 prompt 的事,而是它处理一整个开发会话的效率。
一个典型的工程任务可能得读好几个文件、搞懂现有架构、生成代码、调试报错,再反复迭代几轮把实现打磨好。
用下来我发现,Opus 用起来更贵,尤其是 token 消耗在一次次迭代里越攒越多的时候。
成本差距在哪儿变得明显
看 GPT-6 Sol 和 Claude Opus 5.5 公开的 API 定价:
| 模型 | 输入 / 1M token | 输出 / 1M token |
|---|---|---|
| GPT-6 Sol | $2.00 | $10.00 |
| Claude Opus 5.5 | $4.00 | $20.00 |
Opus 5.5 每个未缓存的输入和输出 token 都贵一倍。
举个例子,假设一个任务涉及 100,000 输入 token 和 20,000 输出 token:
| 模型 | 预估成本 |
|---|---|
| GPT-6 Sol | $0.40 |
| Claude Opus 5.5 | $0.80 |
这只是用公开 API 费率算的示意,不是我某次会话的实测 benchmark。实际成本取决于缓存、推理 token、工具调用,还有具体的模型版本。
从我亲身体验来说,更让我在意的是,Opus 在我工作流里还会消耗更多 token。当 token 数量和单 token 价格都更高的时候,差距就越来越明显了。
我的开发工作流
我主要用 AI 模型干这些事:
- 后端工程: 理解并修改 TypeScript 服务、API 和数据库集成。
- AI agent: 设计工具调用流程、检索管线,还有编排逻辑。
- 调试: 排查跨组件的意外行为。
- 架构: 权衡系统可靠性、扩展性和实现的取舍。
这些不是孤立的一次性 prompt,而是迭代式的工程工作流——模型要反复消费项目上下文,产出中间的推理、代码和解释。
这正是 token 效率变得重要的地方。
我偏爱 GPT-6 Sol,不是说它每个 coding benchmark 都赢,而是基于在一整个开发会话里反复用这些模型的经济账。
我没有收集过一套严格对照、逐条 prompt 对照、设置完全一致、token 日志齐全的 benchmark,所以我不会宣称自己测出来 token 消耗降了具体百分之多少。
让我眼前一亮的地方
对我常做的工程活儿来说,GPT-6 Sol 的成本结构更香。
它的定价让我更容易为多跑几轮迭代、更长的调试会话、更广地探索方案去找理由。
对于做 AI 产品的人来说,更低的推理成本也不只是个人效率问题,它直接决定了 agentic 工作流在规模化运行时能有多经济。
不尽如人意的地方
我的对比主要是成本效率,不是全面的能力排名。
Claude Opus 在复杂的编程和推理任务上依然是个强选项,有些场景下它的输出可能对得起那个溢价。
另外,光看公开的单 token 定价,没法判断哪个模型在某个具体任务上更高效。真正要评估,得在可比条件下测总 token 消耗、正确率、重试次数和完成率。
我的结论:GPT-6 Sol 值不值?
值。GPT-6 Sol 是我默认的首选,而不是 Claude Opus。
我不太在乎哪个模型在某个孤立 demo 里稍微好那么一点,我更在乎哪个在真实开发工作里花同样的钱能给我最好的结果。
就我的体验而言,Opus 在 token 消耗上更贵,而它更高的单 token 价格又把差距放大了。
在看到一个能抵消那部分额外开销的稳定输出质量提升之前,GPT-6 Sol 对我来说依然是更务实的选择。
我的结论:最好的编程模型不一定是最强的那个,而是那个能让你以可持续的成本交付可靠软件的那个。